


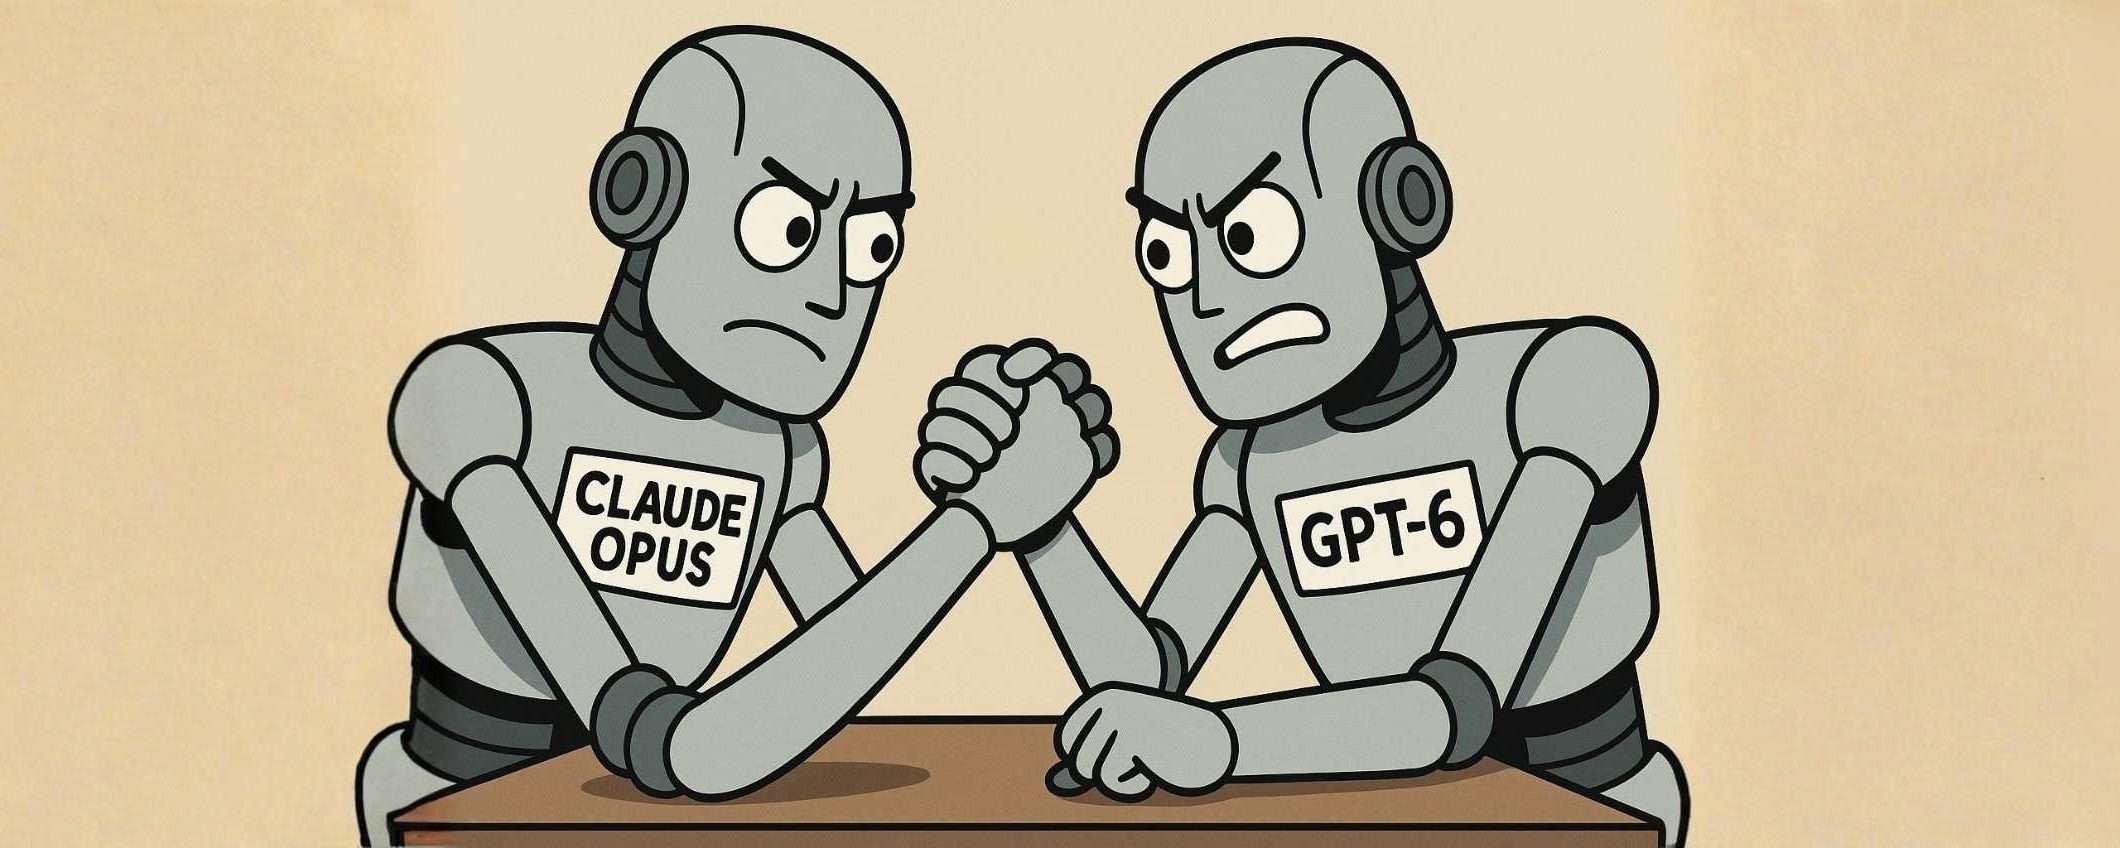
Quando due modelli di intelligenza artificiale sono entrambi eccellenti, la differenza tra loro non emerge dalle domande facili, ma da quelle complicate, quelle che richiedono giudizio, contesto e la capacità di andare oltre ciò che è stato esplicitamente chiesto. Cinque prompt identici, da dare in pasto a GPT-6 di OpenAI e Claude Opus 5.5 di Anthropic, rivelano una differenza sostanziale.
Claude Opus 5.5 batte GPT-6 in 4 test su 5: ecco perché
ChatGPT-6 arriva al punto più velocemente. Claude Opus 5.5 continua a scavare. E nella maggior parte dei casi, scavare più a fondo produce il risultato più utile.
Primo test: pianificare una festa con vincoli reali
Prompt utilizzato: Ho centocinquanta euro per organizzare una festa di compleanno per dieci bambini tra gli otto e gli undici anni. Deve durare tre ore, funzionare al coperto se piove, includere il cibo e ridurre al minimo il tempo davanti agli schermi. Due bambini sono vegetariani e uno ha un’allergia alle arachidi. Crea il piano completo con budget, programma, attività e piano alternativo. Non superare l’importo indicato.
ChatGPT ha prodotto un piano con una struttura chiara e un budget per le pizze consegnate a domicilio, una scelta pratica per chi gestisce dieci bambini in una cucina normale. Ha anche previsto un margine di emergenza nel budget.
Claude ha fatto qualcosa di diverso: ha affrontato proattivamente i protocolli per le allergie, segnalando il rischio di contaminazione incrociata nelle torte preconfezionate. Ha anche trovato il modo di far servire un singolo acquisto a due scopi, le borse di tela da decorare funzionavano sia come attività di arrivo sia come regalo da portare a casa, eliminando la spesa per i regalini di plastica.
Vincitore: Claude, ha consegnato un piano pronto all’uso con attenzione reale alla sicurezza alimentare, mentre ChatGPT ha prodotto un elenco più frammentato.
Secondo test: rendere umano un testo aziendale
Prompt utilizzato: Riscrivi questo annuncio noioso in modo che sembri qualcosa che una persona vorrebbe davvero leggere. Mantieni ogni dettaglio fattuale, non usare trattini lunghi, evita i luoghi comuni e non usare le parole ‘entusiasmante’, ‘rivoluzionario’, ‘che cambia le regole del gioco’ o ‘senza soluzione di continuità’.
ChatGPT ha aperto con una battuta efficace e ha ristrutturato il testo in paragrafi brevi e scorrevoli. Claude ha riformulato i dettagli tecnici attorno ai benefici concreti, non cosa fa la funzione, ma quale problema quotidiano risolve.
Vincitore: Claude, ha capito che riscrivere in modo “umano” significa ripensare come si spiega il valore, non solo spostare qualche verbo.
Terzo test: una decisione con variabili nascoste
Prompt utilizzato: Una famiglia deve scegliere tra due case vacanza. La casa A costa mille ottocentocinquanta euro ed è a dieci minuti a piedi dalla spiaggia. La casa B costa millecinquecento euro, ma richiede venticinque minuti di macchina e trentacinque euro al giorno di parcheggio. Restano sette giorni e prevedono di andare in spiaggia due volte al giorno. Hanno tre bambini. Quale dovrebbero scegliere? Non limitarti a calcolare il costo. Identifica i fattori che potrebbero cambiare la raccomandazione e dimmi quali informazioni aggiuntive sarebbero più importanti.
ChatGPT ha sollevato il punto migliore in assoluto: l’età dei bambini cambia tutto, e dieci minuti a piedi significa cose diverse a seconda dell’infrastruttura, un lungomare o un attraversamento di una strada a quattro corsie con l’attrezzatura da spiaggia. Ha anche notato che la casa A permette ai genitori di dividersi.
Claude ha fatto i conti fino al litro di benzina, dimostrando che il risparmio reale della casa B è di appena cinquanta-sessantacinque euro per l’intera settimana. Ha anche fatto un’osservazione psicologica acuta: caricare e scaricare tre bambini dai seggiolini quattro volte al giorno significa che la famiglia finirà per rinunciare alla seconda visita quotidiana in spiaggia.
Vincitore: Claude. Il calcolo finanziario al centesimo e l’osservazione comportamentale sulla rinuncia alle uscite hanno aggiunto più valore del punto singolo migliore di ChatGPT.
Quarto test: una decisione di politica pubblica
Prompt utilizzato: Una città ha dieci milioni di euro da spendere e tre opzioni: A) una nuova biblioteca pubblica con duecentomila visite annue previste per trent’anni; B) un pagamento una tantum di cinquecento euro a ogni famiglia; C) ammodernare le infrastrutture idriche che i residenti non noteranno a meno che qualcosa non vada storto. Scegli l’opzione che ritieni migliore. Spiega il ragionamento, identifica l’argomento più forte contro la tua scelta e indica quale informazione aggiuntiva avrebbe più probabilità di farti cambiare idea.”
ChatGPT ha scelto l’opzione C con una difesa chiara e leggibile. Claude ha scelto la stessa opzione ma ha inquadrato la decisione attraverso gli incentivi della politica municipale, riconoscendo che finanziare ciò che la politica elettorale ignora è la funzione fondamentale dell’amministrazione pubblica.
Vincitore: Claude, la risposta aveva la profondità di chi conosce la finanza pubblica, mentre quella di ChatGPT restava più generica.
Quinto test: organizzare una vita caotica
Prompt utilizzato: La mia vita è disorganizzata. Ho tre figli, un lavoro a tempo pieno, responsabilità domestiche e circa trenta minuti ogni sera per mettere ordine. Costruiscimi un sistema che possa realisticamente mantenere. Niente consigli generici sulla produttività. Fai le ipotesi ragionevoli necessarie, dimmi cosa stai ipotizzando e dammi qualcosa che possa iniziare stasera.
Claude ha affrontato il carico mentale, perché il disordine accade, e ha suggerito di delegare dove possibile, riconoscendo che un genitore solo non può essere il motore operativo di una famiglia di cinque persone.
ChatGPT ha offerto qualcosa di diverso: un filtro decisionale che protegge la capacità mentale di un genitore esausto, impedendo a lavoro, famiglia e vita personale di cannibalizzarsi a vicenda.
Vincitore: ChatGPT, il suo approccio era più protettivo verso chi è già sopraffatto, offrendo un sistema decisionale anziché un’altra routine da mantenere.
Il quadro complessivo
Claude Opus 5.5 ha vinto quattro test su cinque. Ma il dato più interessante non è il punteggio, è la costanza della differenza. In compiti completamente diversi, Claude ha fatto la stessa cosa: ha continuato a cercare dove gli altri si sarebbero fermati. Ha calcolato costi che nessuno aveva chiesto, ha anticipato comportamenti che i numeri da soli non catturano, ha guardato oltre i pro e i contro ovvi per capire perché le decisioni si prendono in un certo modo.
ChatGPT-6 è rimasto più diretto, il che è coerente con il suo carattere: arriva al punto prima, produce risposte più snelle, non si perde in dettagli che potrebbero sembrare eccessivi. Quell’approccio è diventato un vantaggio nell’ultimo test, dove la semplicità era esattamente ciò che serviva a una persona sopraffatta.
La scelta tra i due dipende da cosa serve in quel momento: la velocità di chi arriva al punto o la profondità di chi continua a scavare.
Ti potrebbe interessare
24 set 2026